日本の自動運転開発において、「LiDAR(ライダー)や高精度3Dマップに頼らず、カメラとAIの視覚情報だけで完全自動運転(レベル5)を実現する」という、テスラと極めて近い設計思想を掲げて注目を集めているのが、2021年設立の国産AIスタートアップ「Turing(チューリング)」です。
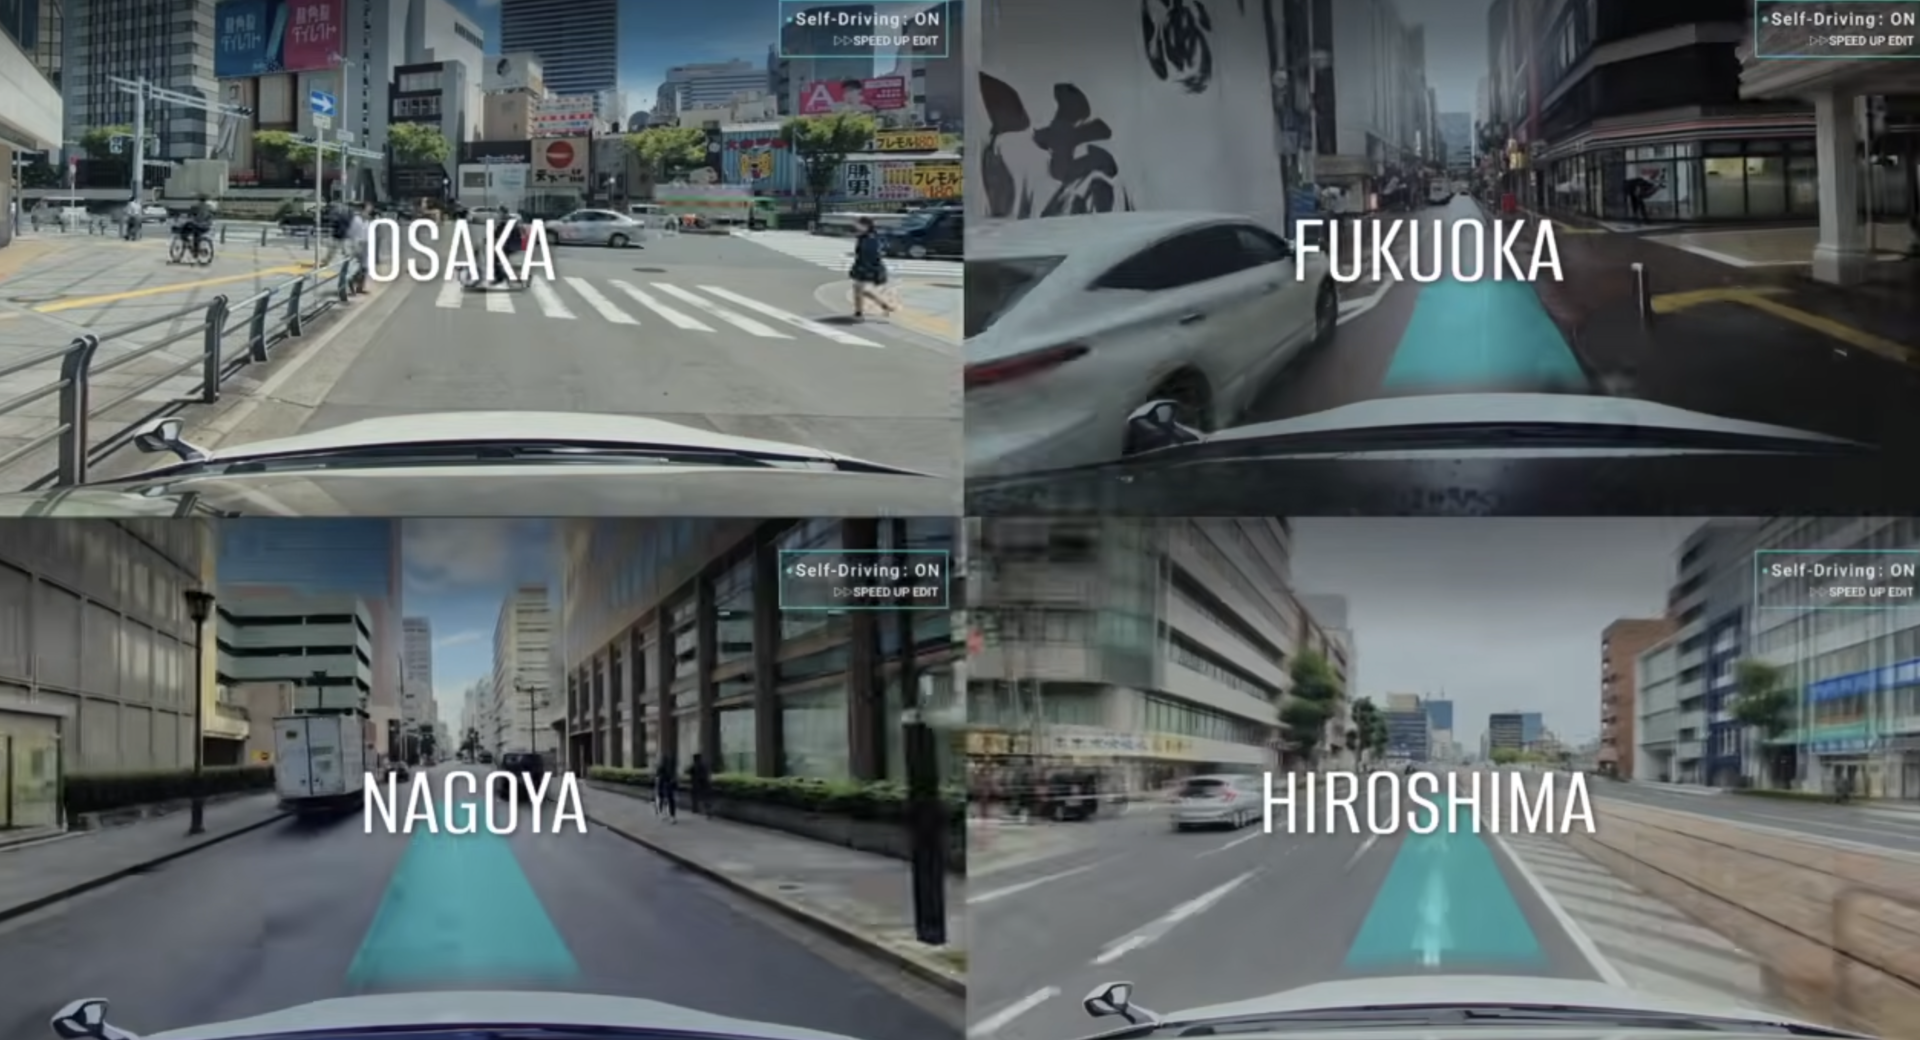
同社は「We Overtake Tesla(テスラを超える)」というミッションを掲げ、市販のミニバンをベースにした改造車両で、東京や大阪など国内5都市での公道走行試験を成功させています。直近では、ほとんど東京のデータのみで学習したAIモデルを用い、初見の大阪・梅田市街地において、カメラ情報と車載AIの判断による走行を成功させたと発表しました。
多くの国内自動車メーカーや自動運転実証実験がLiDARセンサーの多重配置やミリ波レーダー、高精度3Dマップ(HDマップ)の事前整備を前提とする中で、なぜチューリングはテスラと同様の「カメラ+End-to-End(E2E)AI」のアプローチを選択したのか。そして、先行するテスラFSD(Supervised)や次世代チップ「AI5」・巨大クラスタ「Cortex」と比べたとき、何が異なり、どのような技術的課題と計算基盤に挑んでいるのかを客観的に紐解きます。
LiDAR全廃でカメラ7台。アルファードをベースにした「テスラ方式」のハードウェア構成
従来の自動運転実証車両といえば、ルーフ上に巨大な回転式LiDARが鎮座し、車体の四隅やバンパー内にミリ波レーダーや超音波センサーが隙間なく埋め込まれている姿が一般的でした。しかし、センサー点数が増えるほど部品コストは跳ね上がり、センサー同士のデータ同期(センサーフュージョン)におけるソフトウェアの計算負荷も増大します。
チューリングが開発車両として採用したのは、トヨタの市販ミニバン「アルファード」です。この車両に施されたハードウェア改修は、業界の従来手法とは一線を画しています。
1. カメラ配置と死角ゼロの視界設計
開発車両には、前方監視用に2台、左右側方に計4台、後方に1台の計7台の車載カメラが設置されており、これに加えて揺れや加速を測るセンサー(IMU)、衛星測位の受信機(GNSS)、そして車載計算機(NVIDIA Orin)のみを搭載しています。高価なLiDARやミリ波レーダーは一切搭載されていません。7台のカメラ画角を組み合わせることで車両周囲360度の死角を排除しており、これはテスラの現行ハードウェア(HW4)が搭載するカメラ構成(フロント、サイドピラー、フェンダー、リアカメラ)と極めて類似した設計思想です。
2. 高精度3Dマップを排したビジョン主体の認識モデル
一般的な自動運転システムは、あらかじめ道路の白線位置や信号機、標識の高さをセンチメートル単位で測定した「高精度3Dマップ」上を自車位置と照合しながら走行します。これに対し、チューリングのシステムは事前マップを持たず、走行中にカメラが捉えた映像からリアルタイムに道路構造、通行可能空間、信号機の現示、歩行者や他車両の挙動を直接推定します。

End-to-Endモデルの壁。GPUを並べるだけでは解けないデータと計算基盤の課題
チューリングが大阪・梅田の市街地走行で確認した成果の核心は、「事前の学習データをほとんど持たない未走行エリアでも、破綻せずに自律走行できた」という汎化性能にあります。
従来のルールベース型自動運転プログラムでは、「もし赤信号なら停止する」「歩行者が横断歩道にいたら手前で停止する」といった無数の条件分岐コード(If-Thenルール)を手作業で記述していました。しかし、日本の複雑に入り組んだ市街地や変則交差点では、人間の手で記述しきれないエッジケースが無数に発生します。
1. 初見の道路を走行できた理由(約1億パラメータのE2Eモデルと汎化性能)
チューリングのE2E自動運転AIは、カメラの映像、ウインカーの信号、自車の走行状態を1つのAIに入力し、ハンドル操作と加減速を直接出力する構造を採用しています。走行中の車内では判断や操作の遅延が許されないため、クラウドを介さず車載用チップ「NVIDIA Orin」上でリアルタイム処理できるよう、AIモデルの規模は約1億パラメータとコンパクトに抑えられています。ほとんど東京のデータのみで学習したモデルでありながら、初見の大阪・梅田を破綻なく走行できた背景には、視覚情報から直感的に運転操作を導き出すE2Eモデル特有の汎化性能があります。
2. 月200個のモデルを生む「MLOpsサイクル」とペタバイト級データの壁
同社は「走行データ収集 ➔ 前処理・アノテーション・選別(キュレーション) ➔ AI学習 ➔ 机上・実車評価」というMLOpsサイクルを回し、月に約200個ものAIモデルを開発しています。しかし、データ量が10GB〜100GBの段階では回っていた仕組みも、100TB、1PB(ペタバイト)、10PBへと拡大するにつれ、単にGPUを増設するだけでは開発速度が上がらなくなる壁に直面しました。大容量の走行動画データを扱うフィジカルAIでは、ストレージの読み書き(I/O)やネットワーク転送がボトルネックとなり、高価なGPUが計算待ちで遊んでしまうためです。
テスラAI5・Cortexと何が違うのか? Google「TPU v6e」活用と車載チップの現在地
この計算基盤の壁を突破するため、チューリングが選んだアプローチと、先行するテスラの垂直統合体制を比較すると、両者の現在地が鮮明に浮かび上がります。
1. 「GPUより約3倍速い」Google製チップ「TPU v6e」と4階層ストレージの採用
チューリングは2026年4月、Google Cloud上に「NVIDIA H200 GPU」8基搭載の仮想マシンを30台(計240基)並べた新計算基盤をわずか2週間で構築し、Cloud Storage・Filestore・Managed Lustre・仮想マシン直結SSDを組み合わせた4階層ストレージ設計でI/Oボトルネックを解消しました。さらに注目すべきは、GoogleがAI処理向けに開発した半導体「TPU v6e」の活用です。H200が1基あたり月約125万円、TPU v6eが4チップで月約128万円と同等のコストでありながら、ターゲットとする約1億パラメータ規模の画像系AIモデル2種の学習時間を計測した結果、H200の「370秒・406秒」に対してTPU v6e(4チップ構成)は「123秒・111秒」と約3倍の高速化を実現しています。
2. 車載SoC(NVIDIA Orin vs テスラAI5)とデータ収集フリート規模の差
一方で、車両側のハードウェアとデータ収集規模においてはテスラとの間に明確な構造差があります。テスラは車載推論チップをHW3、HW4、そして次世代の「AI5」へと自社で内製設計しているのに対し、チューリングの現行開発車両は市販の車載用SoC「NVIDIA Orin」を搭載して稼働しています(将来的な車載LLM実装に向けた独自半導体チップの研究開発も並行して推進)。また、世界中で数百万台のオーナー車両からコーナーケース映像を自動収集し、自社スーパーコンピュータ「Dojo」や巨大クラスタ「Cortex」で学習させるテスラに対し、限られた試験車両台数で開発を進めるチューリングにとっては、今回構築したデータセントリックな学習基盤の効率をいかに極限まで高められるかが勝負の鍵となります。

日本の道路環境で完全自動運転を実現するための技術的ハードル
カメラ主体のビジョン方式でテスラを追うチューリングにとって、日本市場特有の道路環境への最適化は大きな強みになり得る反面、厳格な法規制の壁も立ちはだかります。
1. 狭小路・歩行者混在空間における日本特有のエッジケース
米国の整然とした格子状道路や広い車線幅に比べ、日本の生活道路は道幅が狭く、歩道と車道が分離されていないゾーン30エリアや、電柱・路上駐車車両を避ける対向車とのすれ違い(離合)が日常的に発生します。こうした「譲り合い」や「アイコンタクト」を含む暗黙の了解をカメラ映像のみから推論し、自然な速度で通り抜ける技術は、海外先行のシステムにとっても最大の難所です。
2. 国交省の型式認証と保安基準への適合プロセス
技術的な走行検証の先には、国土交通省が定める道路運送車両法の保安基準適合と型式指定の取得が必要です。運転席が無人の状態で作動する「レベル4」以上の自動運転装置については、作動継続困難時の安全停止(ODD外での安全退避)やサイバーセキュリティ対策、作動状態記録装置(DSSAD)や事故時のデータ記録装置(EDR)の搭載など、多岐にわたる適合試験が求められます。単にAIが走れるだけでなく、ハードウェアの故障耐性(リダンダンシー)を自動車メーカー基準で保証できるかが、量産化への分水嶺となります。
参考情報




※免責事項:この記事は主にテクノロジーの動向を紹介するものであり、投資勧誘や法律の助言などではありません。また、記事の正確性を保証するものでもありません。加えて、記事内のリンクにはアフィリエイトリンクが含まれていることがあります。また、掲載情報によって起きたいかなる直接的及び間接的損害に対しても、筆者・編集者・運営者は一切責任を負いません。更に、運営者はテスラ株式のホルダーです。
コメント